Reti neurali e deep learning nell'apprendimento supervisionato
Un'introduzione ai concetti fondamentali, alle tecniche e alle applicazioni
In ambito deep learning esistono tre tipi di apprendimento che una rete neurale artificiale può adottare: apprendimento supervisionato, non supervisionato e per rinforzo.
Nell'apprendimento supervisionato la rete apprende da dati etichettati. L'output desiderato - il target y - è determinato a priori dai dati di addestramento. Ad esempio se la rete che vogliamo creare deve imparare a distinguere le immagini dei gatti dalle immagini dei cani, il dataset - o dataframe - conterrà delle immagini di cani e gatti etichettate con delle stringhe di testo: "cane", "gatto", rispettivamente per le immagini dei cani e dei gatti. La rete quindi durante la fase di addestramento deve minimizzare la differenza tra l'immagine contenuta nel dataset - ytrue - e la sua predizione - ypred - alla fine dell'addestramento.
Ma andiamo più nel dettaglio.
Architettura di una rete neurale
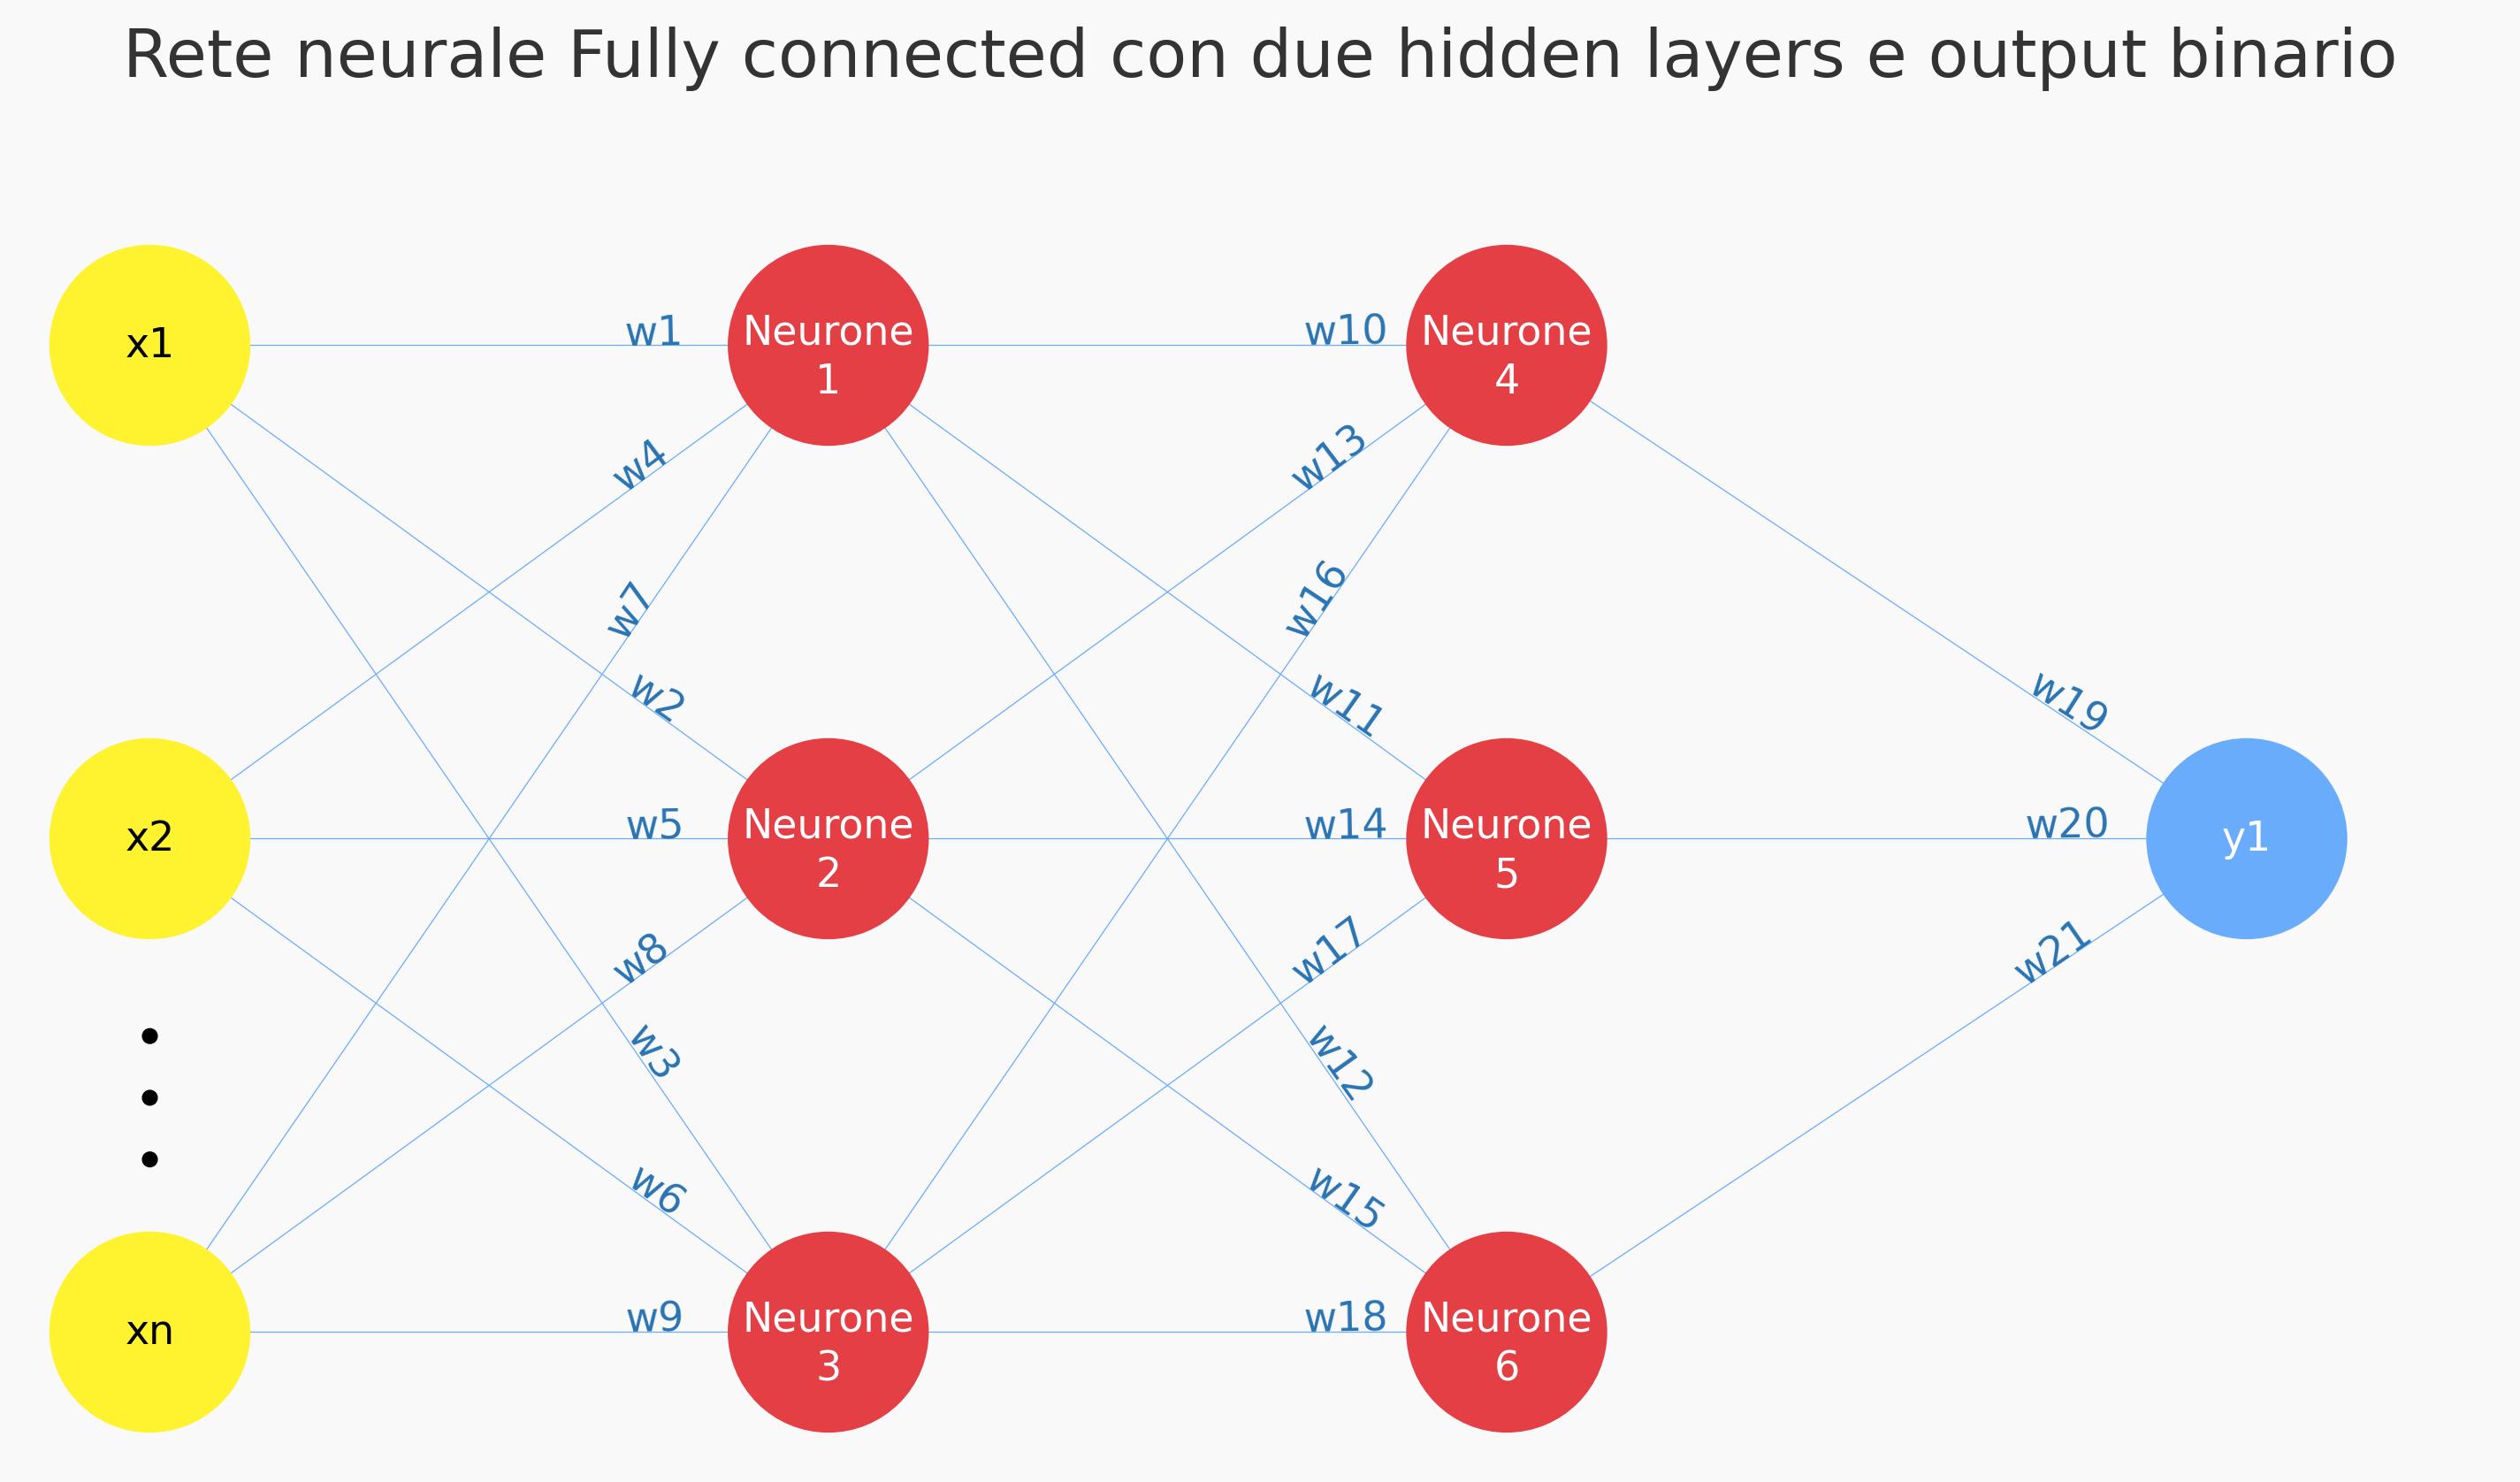
Una rete neurale molto semplice è formata dallo strato di input, da un hidden layer e dallo strato di output ma possiamo aumentarne la complessità aggiungendo diversi hidden layers con strati densi - o fully connected -, strati convoluzionali, strati ricorrenti, LSTM e GRU e ogni strato può avere numerosi neuroni.
Suddivisione del dataset
Ritorniamo al nostro dataset di immagini di cani e gatti, dopo aver svolto un'attenta analisi dei dati a nostra disposizione, per prima cosa dobbiamo suddividere il dataset in training set, validation set e test set.
Di norma si usa dare un 70% dei dati del dataset al set di training, un 15% al set di validazione e il rimanente 15% al set di test. Ma è valida anche la suddivisione 80/10/10.
I dati del set di training, nel nostro esempio le immagini, costituiranno gli input - Xi - con le rispettive etichette associate "cane" e "gatto" - yi - della rete neurale che vogliamo creare. Per semplicità durante la costruzione del dataset possiamo far coincidere l'etichetta "gatto" con il valore numerico 0 e l'etichetta "cane" con il valore numerico 1 in modo da non dover applicare successivamente la tecnica del Label Encoding durante il pre-processing dei dati per convertire le variabili categoriali in formato numerico.

Quindi se abbiamo un dataset contenente 100 immagini avremo un tensore - una matrice di matrici di pixel - contenente X1, X2, X3, X..., X100 e le rispettive label "cane" e "gatto" y1, y2, y3, y..., y100.
I valori di input a seconda del tipo di modello e dei dati specifici che si stanno utilizzando, possono essere o normalizzati scalando i valori dei pixel in un intervallo compreso tra 0 e 1, utile quando si vuole che tutti i valori siano positivi e compresi tra 0 e 1; oppure standardizzati sottraendo la media e dividendo per la deviazione standard dei pixel. Questa formula
x_standardizzato = (x - media) / deviazione_standard
centra i dati intorno allo zero con deviazione standard di 1. Particolarmente utile per stabilizzare l'addestramento delle reti neurali e per rendere l'ottimizzazione più efficiente.
Entrambe le tecniche hanno lo scopo di migliorare la convergenza durante l'addestramento, prevenire problemi di scala tra diverse caratteristiche (features) e rendere l'apprendimento più veloce e stabile.
I dati quindi vengono trasferiti al primo strato nascosto - hidden layer -.
Problemi di classificazione
Possiamo avere problemi di classificazione binaria come il nostro dataset di esempio contenente immagini di cani e gatti - solo un animale per ogni immagine - . Ogni immagine avrà una sola classe: "cane" o "gatto".
Problemi multilabel, in cui ogni esempio può avere più di una classe associata come in un dataset contenente commenti tossici, dove ogni commento può appartenere a più categorie contemporaneamente: "tossico", "odio raziale", "insulti", "minacce".
Problemi di classificazione multi-classe, in cui ogni esempio appartiene esattamente a una sola classe tra molteplici opzioni. Un esempio di questo tipo è un dataset contenente immagini di capi di abbigliamento dove ogni immagine raffigura un solo tipo di capo e nel dataset sono presenti più label, "pantaloni", "t-shirt", "scarpe", "cappello". In questo caso ogni immagine appartiene a una sola classe e il modello deve identificare a quale appartiene.
Forward pass
In questa fase iniziale dell'addestramento chiamata forward pass, ogni neurone del primo strato nascosto riceve tutti i valori di input - come indicato dalle frecce nella prima immagine - e ciascun valore di input Xi viene moltiplicato per un peso associato wi - valore inizialmente casuale per inizializzare la rete - dal neurone stesso. Il neurone calcola quindi una somma ponderata - z - di tutti questi valori:
z = w1x1 + w2x2 + ... + wnxn + b
e aggiunge b, il bias, che è un valore costante inizialmente casuale anch'esso, aggiunto per aumentare la flessibilità del modello e rappresentare relazioni complesse, anche quando tutti gli input sono nulli, spostando la somma ponderata lontano dallo zero.
Il peso w influenza quanto input viene passato da un neurone all'altro. È un valore che collega i neuroni tra i diversi strati della rete e viene ottimizzato per ridurre l’errore tra le predizioni della rete ypred e i valori reali ytrue del dataset. Più il valore del peso è alto e più sarà alto il valore di input di un neurone, di conseguenza il valore di output di quello stesso neurone avrà più importanza rispetto ad un valore di output minore di un altro neurone.
Funzione di attivazione
Durante il forward pass la rete attraverso una funzione di attivazione a = f(z) attiva la somma ponderata z e la trasforma in un valore utile che rappresenterà l'input per il neurone dello strato nascosto successivo. Questa attivazione si ripete strato dopo strato fino all'output.
La funzione di attivazione introduce non linearità permettendo alla rete di apprendere relazioni più complesse come curve, superfici o confini non lineari tra classi ed è fondamentale nelle reti neurali in quanto un modello lineare z = w1x1 + w2x2 + ... + wnxn è semplice e può separare solo dati che siano divisibili da una linea retta, quindi che si trovino solo a destra o a sinistra di questa retta. Se i dati invece non sono separabili linearmente - ad esempio, due classi che formano un cerchio uno dentro l’altro -, un modello lineare fallirà.


Le funzioni di attivazione trasformano l'output lineare di un neurone, la somma pesata z = wx + b, in una forma non lineare.
In alcuni casi le funzioni di attivazione possono mantenere la linearità, come la Relu per valori positivi
f(x) = x (per x > 0)
Senza funzioni di attivazione non lineari una rete neurale è equivalente a una singola trasformazione lineare anche se ha più strati perdendo la capacità di apprendere relazioni non lineari nei dati. Questo la rende equivalente a un singolo percettrone - singolo neurone - limitandone drasticamente le capacità di apprendimento e rendendola inadatta a risolvere problemi complessi.Le funzioni di attivazione più usate sono la Step function, la Tanh, la Relu , Leaky Relu, Elu e Swish per gli strati nascosti, Sigmoide e Softmax nello strato finale di output.
Regolarizzazione e Dropout
Il dropout è una tecnica di regolarizzazione che viene usata solo durante la fase di training e non durante l'inferenza ed impedisce l'overfitting. Il modello - la rete neurale - si trova in overfitting quando funziona bene sui dati del set di addestramento ma non riesce a generalizzare su nuovi dati mai visti. Questo avviene quando la rete è molto complessa in quanto è formata da un numero elevato di strati e di neuroni.
In questi casi il modello potrebbe memorizzare anche rumore e pattern non rilevanti.
Il dropout disabilita un certo numero di neuroni durante ogni iterazione di training impedendo alla rete di diventare troppo dipendente da determinati neuroni incoraggiandola ad apprendere funzionalità più generalizzate. Disattivando casualmente i neuroni, il dropout addestra efficacemente più "sottoreti" all'interno della rete principale, il che rende il modello complessivo più adattabile e impedisce che memorizzi punti dati specifici.
Dopo aver compreso l'importanza della regolarizzazione per migliorare la generalizzazione del modello, esaminiamo come la rete produce un output per un dato input.
Analogia
Ma torniamo alla fase di addestramento, nel nostro esempio, le immagini del nostro dataset - gli input Xi- attraversano tutta la rete neurale e le informazioni passano da un neurone all'altro tramite i pesi wi e la rete per ogni input Xi, quindi per ogni immagine, produce un valore predetto, un output ypredi.
Nel nostro caso stabiliamo di avere due neuroni di output, quindi avremo in uscita dalla rete un vettore [0, 1].
Esempio di output:
Valore 0: 0.8(interpretabile come "secondo la rete è un cane con probabilità dell'80%").
Valore 1: 0.2(interpretabile come "secondo la rete è un gatto con probabilità del 20%").
I valori rappresentano la probabilità stimata dalla rete.
L’output cerca di rispondere alla domanda: “Dato questo input, qual è la classe corretta?”.
Attraverso una analogia forse sarà più facile capire il comportamento di una rete neurale.
Il bambino che guarda per la prima volta un'immagine è la rete che riceve l'input Xi, la matrice di pixel.
Il bambino che esclama "È un gatto" o "È un cane" è la rete che produce una classificazione con il o i neurone/i di output. È la previsione ypred, un valore numerico che indica la probabilità.
Loss function e Funzione di costo
Per capire come la rete apprende dobbiamo considerare come minimizza l'errore tra output predetto e target attraverso la Loss function e la Funzione di costo.
Come detto in precedenza lo strato finale produce un valore predetto ypred basato sull'input iniziale e sul flusso attraverso la rete e viene confrontato con ytrue che è il valore corretto per quell'input e viene fornito dal dataset di addestramento.
La loss function e la funzione di costo quantificano la differenza tra il valore previsto, ovvero l'output del modello ypred per un dato input e il valore effettivo ytrue presente nel dataset per quell'input attraverso un’operazione su questa differenza.
A seconda del tipo di dati e del progetto da svolgere possiamo utilizzare ad esempio:
- l’errore quadratico medio MSE tramite la funzione (ytrue - ypred)2 utilizzato principalmente per problemi di regressione, penalizzando gli errori più grandi in modo più significativo. Funziona bene qundo gli errori sono distribuiti normalmente ed è preferito in problemi dove gli outlier devono essere fortemente penalizzati.
- la cross-entropy con la funzione logaritmica −[ytrue log(pred) + (1 − ytrue)log(1 − ypred)] utilizzata principalmente per problemi di classificazione binaria e multiclasse. Misura la dissimilarità tra la distribuzione di probabilità predetta e quella reale e lavora bene con output probabilistici come nell'output di una rete neurale con sigmoid o softmax.
Se le previsioni di un modello sono accurate la perdita è piccola, se le previsioni sono imprecise e quindi c'è parecchia differenza tra ypred e ytrue la perdita è grande.
Se ytrue = 1 e ypred è vicino al valore 1 abbiamo una bassa perdita
Se ytrue = 1 e ypred è vicino al valore 0 abbiamo una alta perdita
Se ytrue = 0 e ypred è vicino al valore 0 abbiamo una bassa perdita
Se ytrue = 0 e ypred è vicino al valore 1 abbiamo una alta perdita
C'è una sottile differenza però tra le due funzioni ed è dovuta al fatto che la loss function si riferisce all'errore di un esempio di addestramento, mentre una funzione di costo calcola l'errore medio in un intero set di addestramento - nel nostro esempio le 100 immagini di cani e gatti - o in un mini-batch - un sottoset del dataset -.
La funzione di costo rappresenta quindi l'errore tra valore reale e predizione, restituisce un numero che misura di quanto la rete si è “sbagliata” prendendo in input proprio ytrue e ypred.
Nella maggior parte dei casi il termine "funzione di costo" viene utilizzato come termine generale sia per intendere la loss function che la funzione di costo stessa.
Set di validazione
Un altro concetto importante da introdurre nella fase di addestramento è quello di set di validazione il quale aiuta a monitorare le prestazioni del modello su dati non visti.
Aiuta a valutare la capacità della rete di generalizzare, evitando il fenomeno dell'overfitting citato in precedenza. Durante l'addestramento, la funzione di costo viene calcolata quindi sia sui dati di addestramento sia su quelli di validazione.
Un miglioramento delle prestazioni sul set di addestramento senza un miglioramento sul set di validazione può indicare che il modello sta memorizzando i dati anziché apprendere relazioni utili e generalizzabili. Monitorando il comportamento del modello sul set di validazione, è possibile interrompere l'addestramento quando si verifica un peggioramento delle prestazioni su questi dati, utilizzando tecniche come l'early stopping. Questo approccio aiuta a preservare il bilanciamento tra l'apprendimento delle caratteristiche dei dati e la capacità del modello di generalizzare a dati nuovi monitorando le prestazioni e interrompendo l'addestramento qualora le prestazioni sul set di validazione iniziano a peggiorare.
Gradiente e Backpropagation
Una volta definita la funzione di costo la rete può aggiornare i pesi wi attraverso diversi metodi che si differenziano per come vengono applicati e sono: il Gradient Descent, Stochastic Gradient Descent , Adam, RMSProp, Adagrad, Mini-Batch Gradient Descent.
Questi metodi calcolano il gradiente, che è composto da derivate parziali della funzione di costo.
Essendo una derivata parziale, ogni componente del gradiente misura quanto velocemente cambia la funzione di costo quando si modifica un singolo peso, mantenendo tutti gli altri costanti. Questo calcolo tiene conto dell'intera struttura della rete, della funzione di costo e delle funzioni di attivazione. Il processo inizia dai neuroni di output e si propaga all'indietro attraverso tutti gli strati nascosti e i neuroni della rete fino agli input, completando così un'epoca di addestramento.
Questo propagazione all'indietro viene chiamata Backpropagation.
La rete neurale trovandosi in uno spazio iperdimensionale, utilizza il gradiente per determinare la direzione di massima crescita della funzione di costo, di conseguenza per minimizzare questa funzione, si muove nella direzione opposta al gradiente stesso, cioè giù per la pendenza riducendo gradualmente l’errore e avvicinandosi al minimo della funzione di costo facendo dei passi grandi o piccoli verso il minimo dettati dal learnig rate - tasso di apprendimento -.
Il gradiente quindi serve alla rete neurale a capire come modificare i pesi in modo da ridurre la funzione di costo e, di conseguenza, l’errore.
Immagina di voler scendere da una montagna. Il gradiente indica la direzione più ripida da seguire per scendere, e il learning rate determina quanto grande sarà ogni passo.

Bisogna scegliere un rate adeguato perchè se è troppo basso può portare a convergenza lenta mentre se è troppo alto può portare ad overshooting, una condizione in cui invece di avvicinarsi gradualmente al minimo della funzione di costo, gli aggiornamenti dei pesi "saltano" oltre il minimo causando oscillazioni attorno ad esso o addirittura allontanandosi da esso portando a una divergenza invece che a una convergenza.
Nell'immagine precedente l'iperdimensionalità è semplificata a due dimensioni per rendere il concetto più comprensibile ma in realtà si possono avere anche milioni o miliardi di dimensioni. E questa elevata dimensionalità è una delle ragioni per cui l'addestramento delle reti neurali può essere computazionalmente intensivo.
Finita la backpropagation e aggiornati i pesi e i bias inizia una nuova epoca di addestramento.
Questo processo si ripete per un numero definito di epoche, durante le quali la rete dovrebbe migliorare progressivamente le sue predizioni sui dati di addestramento.
Una volta completato l'addestramento sul set di training validando le prestazioni sul test di validazione, il modello viene testato su dati mai visti, set test, per valutarne la capacità di generalizzare.
Set Test
Alla fine dell'ultima epoca di addestramento, quindi alla fine della fase di training, viene utilizzato il set di test per valutare definitivamente le prestazioni del modello. In questa nuova fase, nel caso durante il training fossero stati disabilitati alcuni neuroni per via dell'uso della tecnica di dropout - ad esempio se il tasso di dropout è stato impostato a 0,5 durante l'addestramento, vuol dire che metà dei neuroni vengono disabilitati -, tutti i neuroni sono attivi, anche quelli che erano stati spenti ma i pesi dei neuroni vengono ridimensionati in base al tasso di dropout usato per tenere conto della diversa struttura di addestramento. Il fattore di dimensionamento è dato da 1 - dropout rate.
Alla fine il modello sarà valutato oltre che dalla funzione di costo anche attraverso le metriche statistiche di accuracy, global accuracy, F1-score, Precision.
Considerazioni finali
È questa enorme mole di calcoli parametrici a livello neuronale per ridurre gli errori ad ogni step che non ci dà idea di cosa accada in modo specifico all'interno della rete, negli strati nascosti. Ed è per questo che è difficile interpretare le singole decisioni della rete stessa.
Una rete neurale complessa può avere milioni o miliardi di parametri - pesi e bias - ognuno ottimizzato per ridurre l’errore. Capire il ruolo di ciascun parametro nel risultato finale diventa praticamente impossibile.
La potenza delle reti neurali deriva proprio dalla loro capacità di trovare relazioni complesse e non lineari nei dati, riuscendo a vedere - ad esempio nelle immagini - determinate combinazioni di bordi, texture, colori, pattern, ..., che noi umani non riusciamo a percepire nei dettagli matematici a causa dell'elevata astrazione, di strutture stratificate e a "n" dimensioni.
Possono identificare correlazioni nascoste come sottili variazioni nei pattern dei pixel in immagini diagnostiche.
Continuando ad evolversi offrono strumenti e software sempre più innovativi per affrontare problemi sempre più complessi in tutti gli ambiti della scienza.